Los últimos meses he estado trabajando en una app que es como Pokémon GO pero con perros reales: una persona toma una foto de un perro, la app reconoce la raza y la agrega a una colección de perros, puedes conseguir logros y participar en retos de temporada, entre otras cosas divertidas. La app se llama Todogs y está disponible en Android e iOS
Así se ve la app:
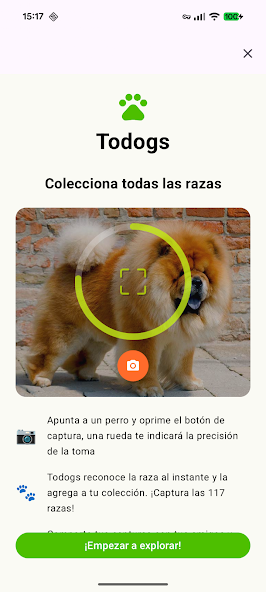
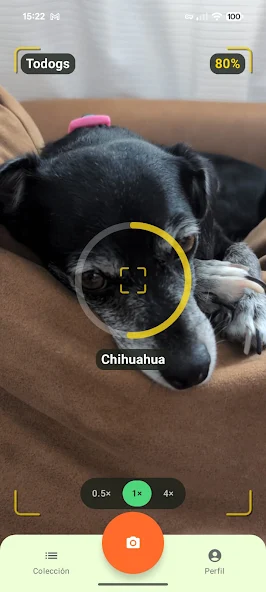
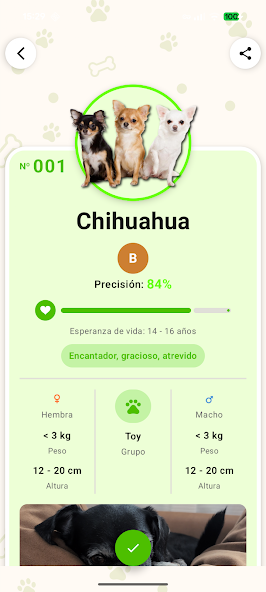
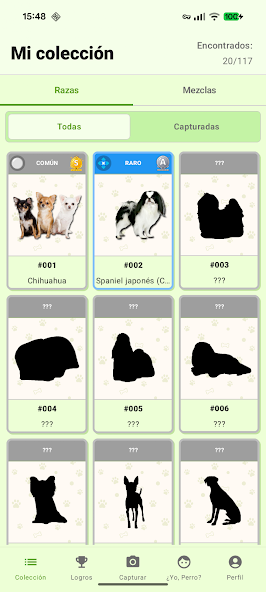
Un gran reto fue hacer que la app funcionara en tiempo real, sin retrasos y sin necesitar conexión a internet para hacer el reconocimiento, así que para eso necesité entrenar mi propio modelo de Machine Learning, para lo cual usé TensorFlow (y TFLite para ejecutarlo). Entrené un modelo con 117 razas y ¡funcionó de maravilla!
Ahora bien, para entrenar un modelo de imágenes como este necesitas un dataset lo suficientemente grande como para que la precisión del modelo sea buena para un producto. Encontré algunos repositorios de imágenes que usé, necesitando alrededor de 150 imágenes para cada una de las 117 razas. El detalle es que, incluso en estos repositorios, hay errores: algunas razas con etiquetas equivocadas, algunas imágenes demasiado oscuras, o con varios perros en ellas, etc.
Además, ahora que quiero que el modelo incluya más razas y siga mejorando, tengo que buscar más imágenes de perros en internet (entre más datos, mejor).
El problema es que el proceso manual es agotador, estos son los pasos:
- Voy a internet y busco una raza, digamos Chow chow.
- Elijo un montón de imágenes y las guardo. Está padre que existen algunos repos con carpetas de perros, eso me ahorra algo de tiempo; para otros perros tengo que elegir las imágenes yo mismo.
- Filtro esas imágenes una por una: reviso que no sean fotos de estudio (el mundo real de los usuarios es más caótico), que los perros no estén cortados, que no haya varios perros en la foto, cualquier cosa que pueda confundir al modelo.
- Muevo las fotos a mi dataset para reentrenar.
Otra cosa que quiero hacer es usar las mismas fotos generadas dentro de la app como datos nuevos para reentrenar el modelo, pero hay muchísimas fotos de baja precisión y no adecuadas; aplicarles el proceso de arriba es simplemente insostenible, necesitaría una persona de tiempo completo para eso.
Entra el Google All Things Agentic Hackathon
Un amigo me pasó el link de este hackathon. El hackathon se trata de aprender a crear agentes de IA con los servicios y plataformas de Google (Cloud Run, Antigravity SDK, Vertex AI, Gemini, etc.) y crear un proyecto usando esas herramientas para resolver un problema que tengas. De inmediato me vino a la mente: “Espera, ¡podría crear un agente para mi problema!”. Así que me puse a investigar y empecé a construir una solución que me va a ahorrar muchísimos dolores de cabeza.
Escribí este artículo como parte de mi participación en el All Things Agentic Hackathon.
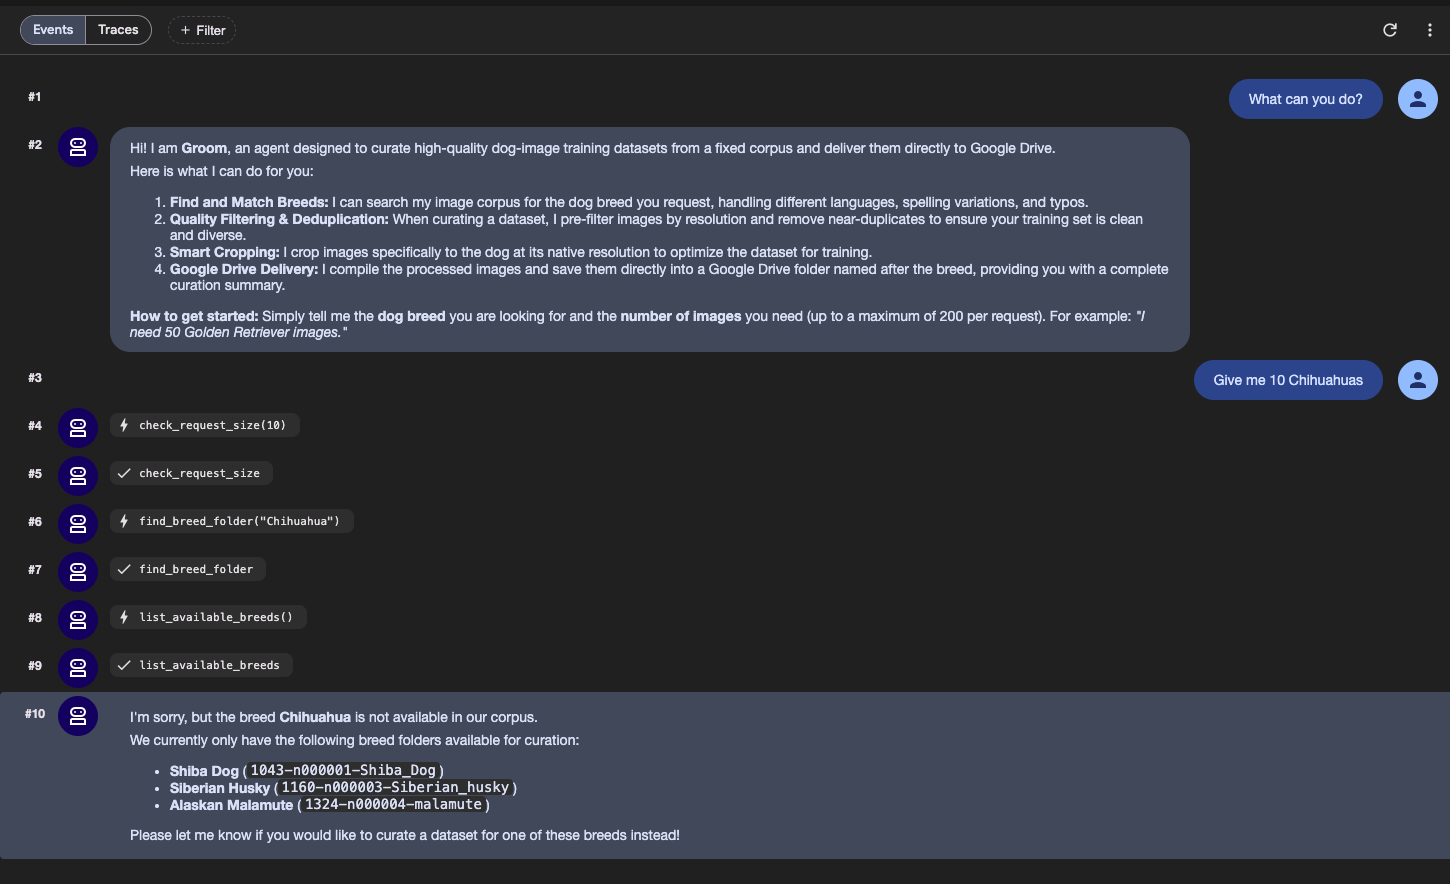
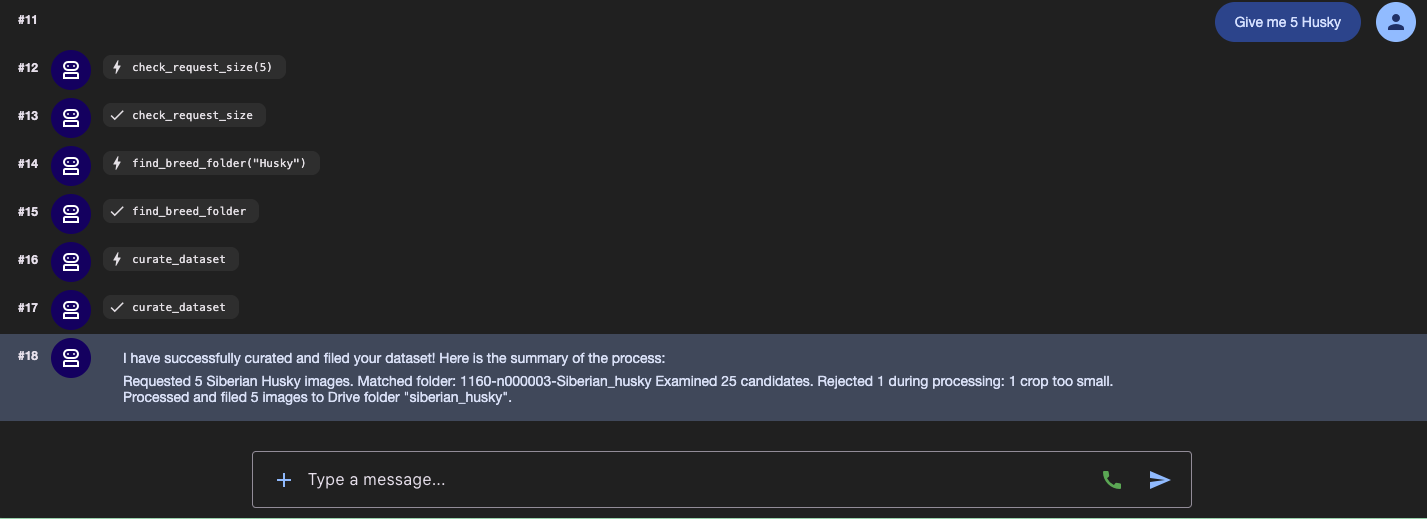
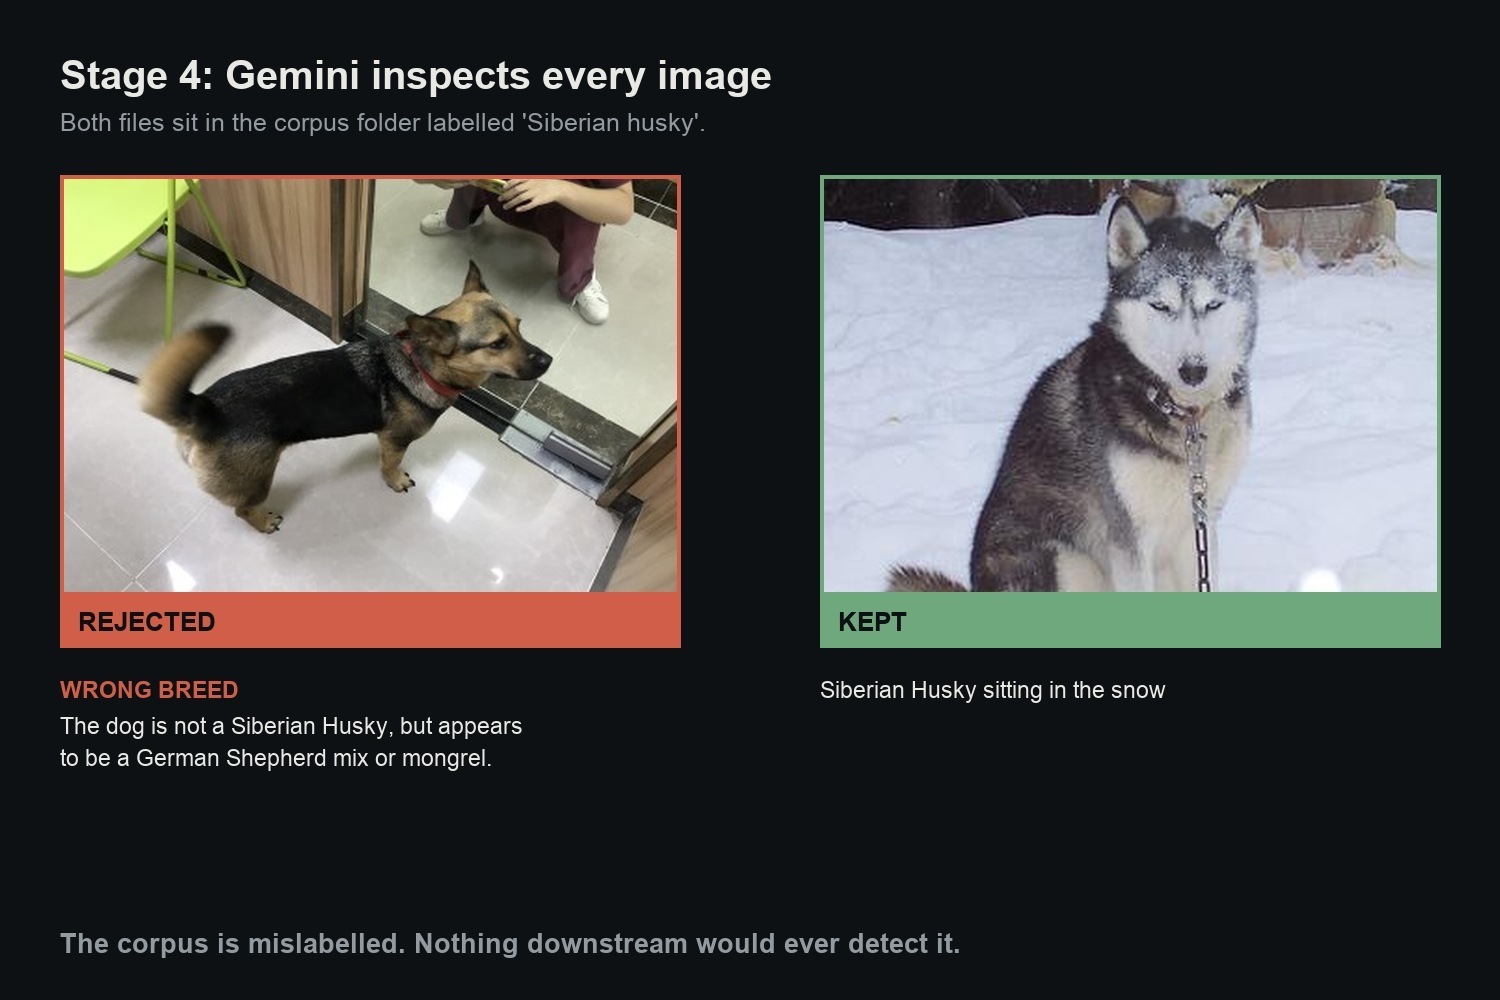
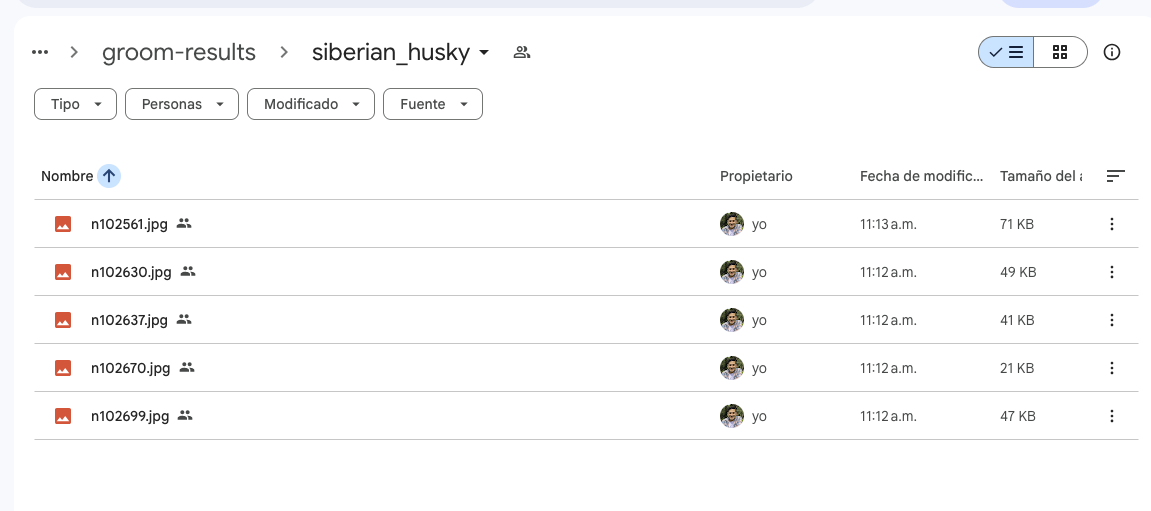
El proyecto que empecé fue un agente de IA que hace todo el proceso descrito arriba en minutos en lugar de semanas. Funciona así: abro el agente, escribo “Dame 100 imágenes de Husky” y va a un repositorio con fotos de muchos perros, elige Husky y va imagen por imagen. Luego empieza a descartar imágenes. Primero las revisiones baratas en Python: cualquier cosa demasiado pequeña, cualquier archivo que ni siquiera abra, y los casi-duplicados detectados con perceptual hashing (así se identifica la misma foto en dos tamaños, no solo los archivos idénticos byte a byte). Después la cara: Gemini revisa cada imagen que sobrevivió y responde las preguntas que yo antes contestaba a mano. ¿Realmente hay un perro? ¿Es la raza que pedí? ¿Hay solo uno? ¿Está lo suficientemente nítida? Y la rara: ¿parece una foto tomada con un celular, o una foto de estudio? Las fotos de estudio son bonitas e inútiles para mí, porque mis usuarios están afuera, con mala iluminación y un perro que no se queda quieto.
De lo que estoy más orgulloso es de que el agente se niega a adivinar. Si le pido una raza que no está en el corpus, se detiene y me lo dice en lugar de entregarme lo más parecido que encontró. Si una petición es genuinamente ambigua, me pregunta a cuál me refería en vez de elegir por su cuenta. Suena a un detalle menor, pero una raza mal identificada envenena un set de entrenamiento de forma silenciosa: nada más adelante en el proceso lo detecta, el modelo simplemente empeora un poco y te enteras meses después. Al final guarda las fotos buenas en mi Google Drive.
Con este proyecto logré varias cosas:
- Aprendí sobre agentes desde cero hasta un producto en producción desplegado en Cloud Run.
- Creé una herramienta que va a ser muy útil y que le va a ahorrar muchísimo tiempo a un proyecto en el que ya estaba trabajando.
- Pude participar en el hackathon con posibilidad de ganar un premio.
Stack utilizado:
- Google ADK
- Google GenAI SDK
- Gemini 3.5 Flash
- Vertex AI
- Cloud Run
- Cloud Storage
- Secret Manager
- Google Drive API
- Python 3.12
- Pillow
- ImageHash
Retos:
- Tuve que aprender en tiempo récord, el hackathon tenía fecha límite.
- Cada imagen inspeccionada es una llamada a Gemini, así que esa es la parte que escala con el tamaño del dataset. La mantengo controlada reduciendo el tamaño de las imágenes antes de enviarlas, usando resolución de medios baja e inspeccionando solo las imágenes que una petición realmente necesita.
- Como era totalmente nuevo en esto, tuve que aprender gran parte del stack desde cero, lo que me retrasó y a veces me hizo retroceder porque había hecho algo mal.
Qué sigue:
- Conectar el agente a mi propio Firebase Firestore para las fotos generadas por los usuarios, para que mi modelo pueda aprender de sus propios errores.
- Idea loca: hacer scraping de la web para no tener que reunir las imágenes yo mismo ni depender de repositorios.
Así que parece que un hackathon del que no sabía nada hace unas semanas me ayudó a resolver uno de mis retos más grandes.